GPT-6 Astra obsługuje komputer, korzysta z narzędzi i wykonuje zadania rozłożone na wiele kroków. OpenAI pokazuje aktualizowanie CRM, przygotowywanie dokumentów oraz budowanie i testowanie aplikacji. Wynik 99,9 procent na ARC-AGI-3 przyciąga uwagę, lecz dla firmy bardziej użyteczna będzie odpowiedź na pytanie, ile pracy model potrafi zakończyć bez kolejnej interwencji człowieka.
W Kuliberda Labs chcemy zmierzyć ten koszt na powtarzalnych zadaniach. Opisany niżej test jest planem; nie mamy jeszcze jego wyników. Publiczne benchmarki pomagają wybrać zadania do sprawdzenia, a ocena konkretnego procesu wymaga pomiaru w jego środowisku. Wyższy wynik Fable 5.1 w Intelligence Index Artificial Analysis nie przesądza o wyborze modelu do firmowego CRM.
Dostępność GPT-6 Astra i resety limitów
OpenAI ogłosiło stopniowe udostępnianie modelu w ChatGPT Plus, Pro, Business i Enterprise oraz przez API, Azure i Amazon Bedrock. W komunikacie o kolejności wdrożenia Sam Altman wskazał Pro jako pierwszą grupę subskrybentów. Administratorzy Enterprise mogą włączyć model dla organizacji; według informacji premierowej dostęp był domyślnie wyłączony.
Dostępność zależy od konta i kanału. W Kuliberda Labs korzystamy już z Astry w Codexie, co nie potwierdza dostępu wszystkich klientów ani możliwości podłączenia modelu w ich systemach. Przed testem sprawdzamy konkretną organizację i jej ustawienia.
We wpisie z 4 września Tibo Thsottiaux z OpenAI zapowiedział na X jeden zachowany reset limitów za każdy dzień bez Astry na płatnym planie ChatGPT. Wzmianka o około trzech godzinach dotyczyła oczekiwania na pierwszy reset. Cytujemy ten wpis jako komunikat jego autora; zasady przyznawania rekompensaty trzeba sprawdzić na swoim koncie.
Źródła: komunikat OpenAI, Sam Altman o dostępie, Tibo o resetach.
Co potrafi Astra poza pisaniem?
W materiałach OpenAI model korzysta z przeglądarki, terminala i aplikacji przez ich interfejs. Dla zespołu oznacza to możliwość zlecenia procesu obejmującego kilka programów, na przykład znalezienia informacji, zapisania ich w zestawieniu i sprawdzenia wyniku na ekranie.
| Rodzaj pracy | Przykłady przedstawiane przez OpenAI |
|---|---|
| Obsługa komputera | Nawigacja po stronach, formularze, aktualizacja CRM, kalendarz |
| Kodowanie | Budowa aplikacji, instalacja zależności, testy, poprawki frontendu |
| Dokumenty | Raporty, slajdy, praca według szablonu |
| Analiza | Research, dane naukowe, wykresy, notacja symboliczna |
OpenAI nazywa Astrę swoim najlepszym modelem do dokumentów i slajdów. Jest to deklaracja producenta, którą uwzględnimy w porównaniu z Fable i Opusem. Film demonstracyjny pokazuje udane wykonanie, ale do oceny powtarzalności potrzebna jest także liczba prób, błędów i interwencji poza opublikowanym fragmentem.
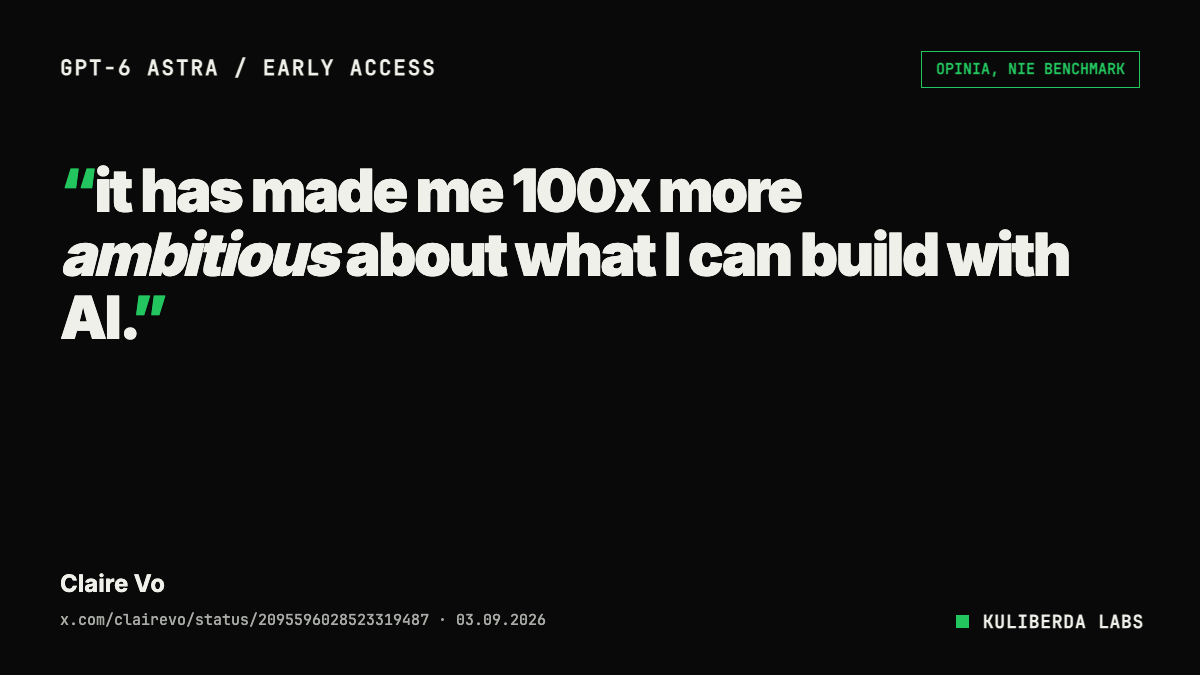
Wczesne relacje użytkowników uzupełniają ten obraz. Claire Vo opisała wzrost ambicji dotyczących tego, co może zbudować z AI. Jej dokładny cytat znajduje się poniżej i odnosi się do osobistego doświadczenia z wczesnym dostępem.
Źródła: przykłady OpenAI, wpis Claire Vo.
Astra, Fable 5.1, Opus 5 i Sol: porównanie benchmarków
W premierowych publikacjach Artificial Analysis z 1 i 3 września Astra uzyskała 61 punktów w Intelligence Index v4.1.1, Sol również 61, Opus 5 wynik 63, a Fable 5.1 wynik 66. W Coding Agent Index Astra w Codexie uzyskała 67, Fable 5.1 w Claude Code zaś 70. Są to zaokrąglone wyniki konkretnych zestawów testów i środowisk, nie ogólna miara inteligencji.
Wynik Fable 5.1 w Intelligence Index pochodzi z ustawienia max z domyślnym przekierowaniem części żądań do modeli Opus; obsłużyły one około 4 procent tokenów wyjściowych. To istotny warunek porównania. Artificial Analysis od tego czasu zmieniło zestaw testów, dlatego przytoczone liczby opisują porównanie premierowe, a nie bieżącą kolejność całego rankingu.
W tabeli OpenAI proporcje zmieniają się zależnie od zadania. Poniżej wyniki procentowe; brak liczby oznacza brak wyniku w tym porównaniu.
| Test | Astra | Sol | Fable 5.1 | Opus 5 |
|---|---|---|---|---|
| OSWorld 2.0, offline, punktacja częściowa | 72,6 | 65,7 | brak | 70,2 |
| AutomationBench | 41,4 | 18,1 | 31,4 | 26,9 |
| Terminal-Bench 4.0 | 57,9 | 37,3 | 55,8 | 52,6 |
| FrontierMath Tier 4 (v2) | 97,6 | 83,0 | 87,8 | 73,2 |
| HLE z narzędziami | 57,2 | brak | 65,0 | 63,6 |
Źródłem tabeli jest OpenAI. Firma zaznacza, że publikuje maksymalne wyniki przy testowanych poziomach wysiłku, a środowisko badawcze i API mogą zachowywać się inaczej niż produkcyjny ChatGPT. Przypisy opisują warianty testów i ustawienia konkurencyjnych modeli. Te warunki mają znaczenie, szczególnie gdy zestawiamy wyniki z innych publikacji.
Dla KL są to kandydaci do porównania: Astrę sprawdzimy w procesach z obsługą komputera, Fable 5.1 pozostaje mocnym punktem odniesienia dzięki wynikom obu indeksów, a Sol pozwoli ocenić, czy wyższy koszt daje odczuwalną korzyść. Dokumenty i prezentacje sprawdzimy na tych samych szablonach oraz kryteriach. Nie ustaliliśmy jeszcze docelowego podziału pracy między modele.
Źródła: Artificial Analysis o Astrze, Artificial Analysis o Fable 5.1, tabele i przypisy OpenAI.
Jak sterować pracą Astry i dobrać harness?
OpenAI udostępnia poziomy wysiłku rozumowania od low do max. W Codexie Astra może zadać pytanie i kontynuować pracę niezależną od odpowiedzi. Operator może też dopowiedzieć warunek w trakcie zadania. To opis dostępnych sposobów współpracy; publiczna dokumentacja nie daje pełnego wglądu w wewnętrzny proces podejmowania decyzji.
Harness obejmuje instrukcje, narzędzia, kontekst i sposób sprawdzania wyniku. W pierwszym teście zaczniemy od krótkiego opisu celu, potrzebnych danych oraz dostępu do aplikacji używanych w procesie. Model powinien widzieć skutki swoich działań i znać warunek ukończenia. Poziom wysiłku dobierzemy do trudności zadania, z pomiarem czasu i kosztu.
Nie ma jeszcze rozstrzygnięcia, które środowisko będzie najlepsze w każdej klasie pracy. Matt Shumer opisał eksperyment z dodatkową sesją koordynującą długie zadania Astry. To pomysł do porównania z prostszym układem, uwzględniający koszt koordynacji. Poradnik migracji Anthropic dostarcza podobnej lekcji przy Opusie 5: długość odpowiedzi, dodatkowa weryfikacja i rozszerzanie zadania wymagają dostrojenia instrukcji. Sam poradnik nie dowodzi skali niezadowolenia użytkowników.
Źródła: karta modelu OpenAI, OpenAI o współpracy w Codexie, eksperyment Shumera, poradnik Anthropic.
Ograniczenia i bezpieczeństwo
OpenAI sklasyfikowało Astrę jako swój pierwszy model na progu Critical w obszarze cyberbezpieczeństwa. W części testów trudniej było monitorować jego wewnętrzne rozumowanie. Raport obejmuje zarazem poprawę przestrzegania granic zadania i zabezpieczeń. W symulacji ponad 54 tysięcy wewnętrznych zadań Codexa Astra otrzymała około połowy mniej flag poważniejszego niedopasowania zachowania niż Sol.
Te wyniki pochodzą z ewaluacji OpenAI i opisują różne aspekty modelu. Większe zdolności cybernetyczne współistnieją z lepszym trzymaniem zakresu w badanych zadaniach. Liczba flag w symulacji nie jest wskaźnikiem incydentów u klientów. Dla wdrożenia nadal liczą się przyznane uprawnienia, kontrola rezultatu oraz reakcja systemu na błąd.
Źródło: raport bezpieczeństwa Astry.
Czy wynik 99,9 procent oznacza AGI?
OpenAI raportuje 99,9 procent na ARC-AGI-3 przy użyciu opisanego w przypisie harnessu Responses API. Wynik dotyczy konkretnego testu i konfiguracji. Szeroka, niezawodna autonomia w pracy ekonomicznej pozostaje osobnym pytaniem.
Connor Leahy w rozmowie z This is IT definiuje superinteligencję przez autonomię i przewagę w szerokim zbiorze ważnych zadań. Jest to wyższy próg niż samo AGI; jego wypowiedź pomaga nazwać kryteria, ale nie rozstrzyga statusu Astry. Dla użytkownika samodzielna praca modelu w aplikacjach może przypominać oczekiwanego ogólnego asystenta. O trwałości tego doświadczenia powiedzą więcej powtarzane zadania niż nazwa benchmarku.
Jak sprawdzimy Astrę w firmie?
Proponujemy pięć powtarzalnych zadań wykonanych przez Astrę i obecny model na porównywalnych ustawieniach. Zapiszemy poprawność rezultatu, czas operatora, korekty oraz całkowity koszt, razem z narzędziami. Nasz roboczy próg to co najmniej 20 procent mniej czasu człowieka bez wzrostu liczby korekt; przed szerszym użyciem sprawdzimy powtarzalność w kolejnych dziesięciu uruchomieniach. To kryteria planowanego pilota, nie wyniki badań KL.
Test możemy rozpocząć od pierwszego dnia dostępności w kanale klienta, jeśli wcześniej zatwierdzimy próbkę, dostawcę, warunki przetwarzania danych i limit kosztu. Wymagania dotyczące danych osobowych i umów ustalimy dla konkretnego wdrożenia. Pierwsze zadania mogą korzystać z danych syntetycznych lub zminimalizowanej próbki. Dostęp do firmowych narzędzi ustalimy dla konkretnego procesu.
Kuliberda Labs przygotowuje asystentów AI dla firm korzystających z modeli frontier. Opisz proces do testu, a dobierzemy próbkę i kryterium, które pozwoli ocenić jego przydatność.
FAQ: GPT-6 Astra
Czy Astra jest dostępna dla wszystkich?
OpenAI udostępnia ją etapami w płatnych planach ChatGPT i kanałach API. Sprawdź dostęp na swoim koncie oraz ustawienia administratora organizacji; obecność modelu u innego użytkownika nie gwarantuje go w Twoim kanale.
Czy OpenAI daje reset co trzy godziny?
We wpisie Tibo Thsottiaux zapowiedział jeden zachowany reset za dzień bez dostępu. Trzy godziny dotyczyły oczekiwania na pierwszy reset. To komunikat z X, którego aktualne wykonanie należy sprawdzić na koncie.
Czy Astra jest lepsza od Fable 5.1?
W przytoczonym porównaniu premierowym Fable 5.1 uzyskało wyższe wyniki w Intelligence Index i Coding Agent Index Artificial Analysis. Astra wypada lepiej w AutomationBench i Terminal-Bench 4.0 z tabel OpenAI; dla Fable 5.1 nie podano wyniku OSWorld offline. Wybór do procesu zależy także od kosztu i liczby korekt.
Ile kosztuje Astra w API?
Standardowe stawki za milion tokenów wynoszą: 10 USD za wejście, 50 USD za wyjście, 1 USD za odczyt cache i 12,50 USD za zapis cache. Powyżej 272 tysięcy tokenów wejścia całe żądanie podlega mnożnikom: 2× dla wejścia i cache oraz 1,5× dla wyjścia. Fast kosztuje 2× odpowiednią stawkę, Batch i Flex 50 procent stawki Standard. Część narzędzi, między innymi wyszukiwanie i obsługa komputera, ma dodatkowe opłaty za wywołania. Kwota za zadanie zależy od użytych trybów, tokenów i narzędzi. Źródło: cennik modelu.
Jakie wejścia przyjmuje model?
Według karty modelu Astra przyjmuje tekst i obrazy, a generuje tekst. Natywne wejście audio i wideo nie jest obsługiwane. System może przygotować transkrypcję lub klatki za pomocą dodatkowych narzędzi. Karta podaje okno kontekstu 1 050 000 tokenów i limit wyjścia 128 tysięcy tokenów.
Czy samo przełączenie modelu wystarczy?
Wynik zależy od instrukcji i dostępnych narzędzi. Po zmianie modelu sprawdzimy te same zadania, zakres działania oraz sposób raportowania, zanim uznamy konfigurację za odpowiednią dla procesu.
Czy KL wdroży Astrę od pierwszego dnia?
Możemy rozpocząć uzgodniony pilot po udostępnieniu modelu w kanale klienta i przygotowaniu próbki, warunków danych oraz budżetu. Decyzję o szerszym użyciu podejmiemy po ocenie wyników.
Źródła i aktualizacja
Redakcja: 8 września 2026. Ponownie sprawdziliśmy dokumentację modelu, ceny, komunikat premierowy, raport bezpieczeństwa oraz przywołane publikacje Artificial Analysis i wpisy X. Dostęp w konkretnym planie i zasady resetów należy sprawdzić na swoim koncie. Opisany test KL pozostaje propozycją pilota bez opublikowanych wyników.
Wróć na początek ↑